Blog · Desempenho
Sistema lento? O que verificar antes de trocar o servidor
Servidor maior às vezes resolve, e muitas vezes a lentidão volta semanas depois. Onde o tempo costuma ir e como achar a causa com dados antes de gastar.
Quando o sistema fica lento, o prejuízo aparece na pior hora. É a nota que leva minutos para sair no fechamento do mês, a fila no balcão, o vendedor esperando a tela abrir com o cliente do outro lado da linha. A reação mais comum é pedir um servidor maior. Às vezes funciona. Muitas vezes a lentidão volta algumas semanas depois, e a empresa passa a pagar mais pela mesma dor.
Lentidão é sintoma, e a causa costuma estar em lugares que mais processador não alcança. Antes de gastar, vale descobrir para onde o tempo está indo.
Primeiro, delimite a lentidão
Quatro perguntas já cortam a busca pela metade.
- É todo mundo ou uma parte? Se só uma filial reclama, o primeiro suspeito é a rede até ela. Se é um usuário só, o problema pode estar no computador dele.
- É o sistema inteiro ou uma tela? Um relatório lento costuma apontar para a consulta que ele faz. Tudo lento aponta para o servidor, o banco ou a rede.
- É o dia todo ou em horários certos? Lentidão às 8h, no fechamento ou no fim da tarde costuma ter hora marcada, como uma rotina pesada ou um backup rodando junto com o expediente.
- Começou depois de alguma mudança? Atualização do sistema, migração, filial nova ou mais usuários são as primeiras pistas.
Onde o tempo costuma ir
Disco
O banco de dados vive no disco. Quando o disco demora para responder, tudo espera, mesmo com o processador folgado. Isso acontece em servidor antigo e também na nuvem, quando o disco contratado entrega menos desempenho do que o banco precisa. O número que importa é a latência, o tempo que cada leitura leva. Para banco de dados, leitura passando de 20 milissegundos com frequência já é sinal de gargalo.
O banco esperando o próprio banco
Um processo longo, como uma importação ou um relatório pesado, pode segurar registros que outras pessoas precisam. Quem vem depois fica na fila, e para o usuário a tela simplesmente congela. O banco registra o que está esperando e quem está bloqueando quem. Esse registro é o mapa da lentidão.
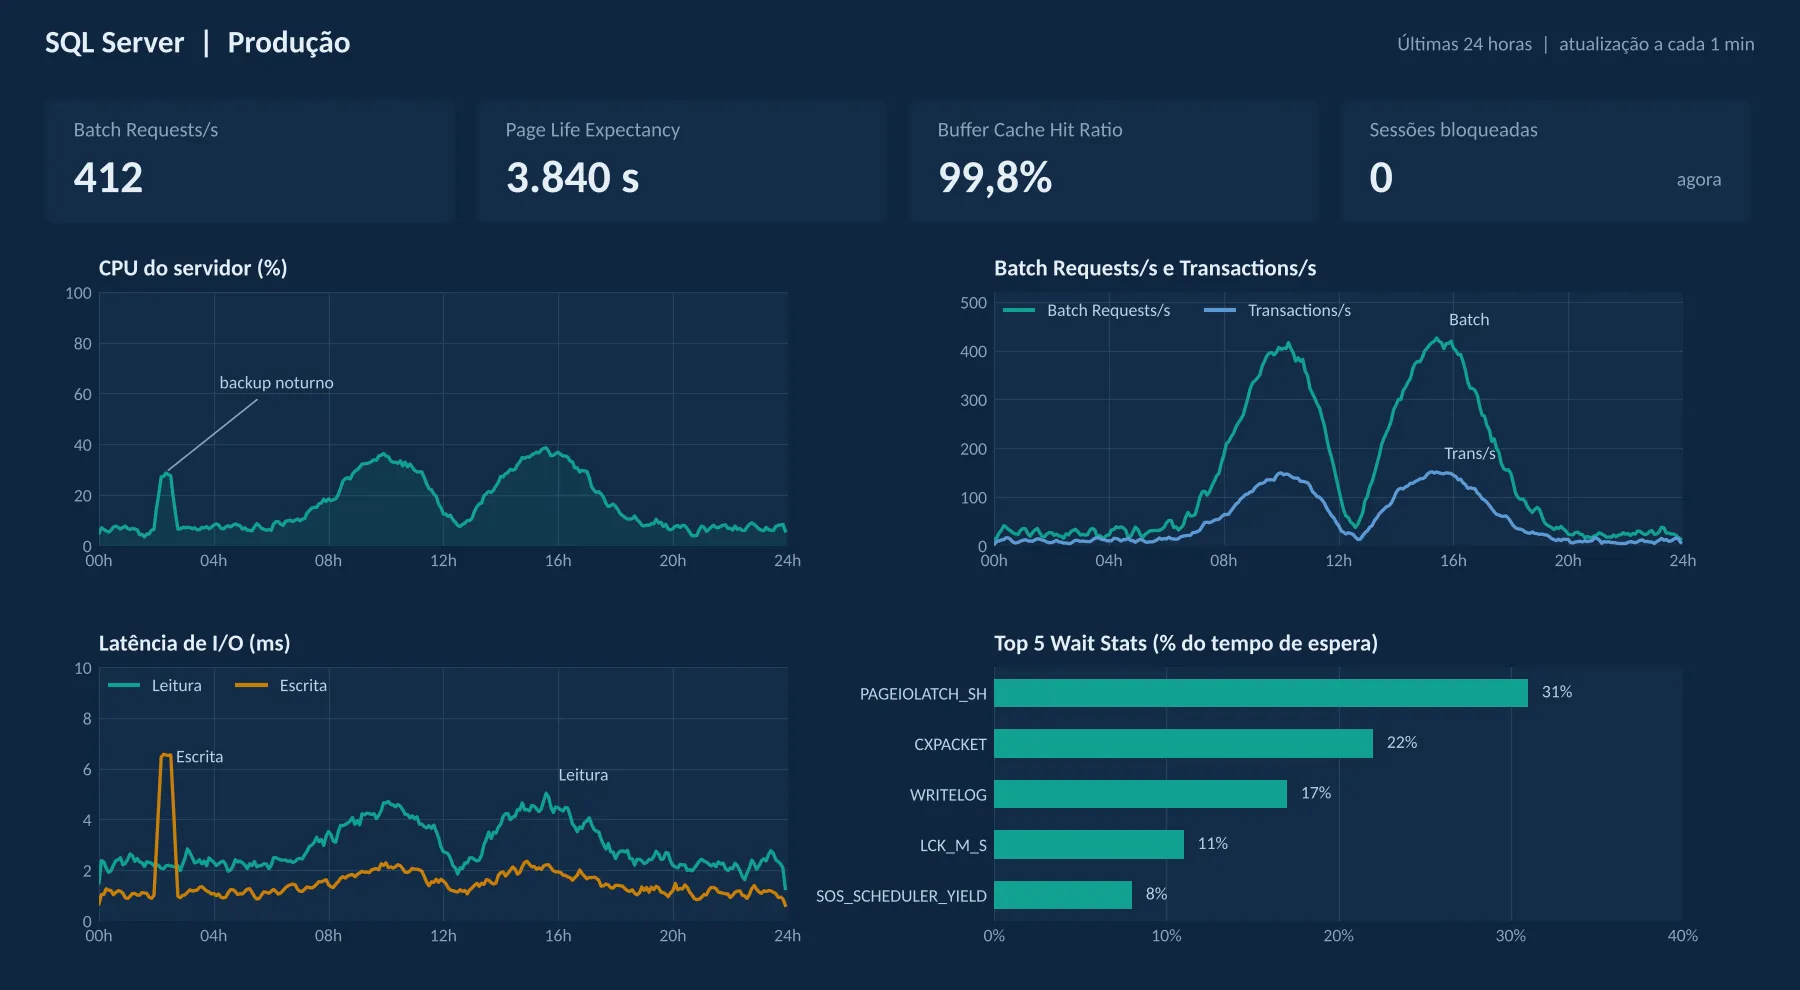
Painel com dados de demonstração.
Memória e a aplicação
Sistemas em Java, como os que rodam em WildFly, param por alguns instantes para limpar a memória. Com memória curta ou mal ajustada, essas pausas ficam longas e frequentes, e o usuário sente travadas de vários segundos sem motivo aparente. No servidor do banco, a falta de memória faz o banco buscar no disco o que deveria estar à mão.
Rede e distância
Muitos sistemas de gestão trocam dezenas de mensagens com o servidor a cada tela. Se cada ida e volta demora, a soma pesa. Link de filial saturado, VPN mal dimensionada e servidor longe dos usuários aparecem aqui. Na nuvem, a região escolhida faz diferença. Já vimos o banco completamente saudável e a lentidão vindo da rota de internet entre a empresa e o servidor.
Tarefas na hora errada
Backup, antivírus examinando os arquivos do banco, manutenção do banco e integrações que importam dados em lote disputam o mesmo servidor com os usuários. Mudar o horário de uma rotina resolve mais lentidão do que parece.
Caso real. Num ambiente que acompanhamos, uma rotina agendada a cada 4 minutos consumia um terço do processador do banco. Em pouco mais de duas semanas, cada execução passou de 39 para 147 segundos. Antes de chegar nela, disco, memória, rede e aplicação foram descartados com número.
Em outro ambiente, um backup completo de quase 500 GB foi disparado à mão às 10h da manhã, junto com uma carga de dados. O processador do banco foi a 90% e as sessões começaram a travar umas às outras.
Por que trocar o servidor nem sempre resolve
Se o gargalo está no disco, nas filas do banco ou na rede, mais processador não muda nada. Na nuvem, a máquina maior ainda aumenta a conta todo mês. Muitas vezes a correção certa é menor e mais barata, como trocar o tipo de disco, mudar o horário do backup, ajustar a memória da aplicação ou corrigir a rotina que segura a fila.
Caso real. Num banco Oracle na nuvem, o processador vivia em 95% e o próximo passo seria dobrar a máquina. A causa era um índice que faltava. Com ele criado, o processador caiu para 56% sem reiniciar nada, e a máquina maior deixou de ser necessária.
Como achar a causa com dados
O caminho é medir durante a lentidão e comparar com um dia normal. Os números que contam são uso de processador e memória, latência de disco, esperas e bloqueios do banco, pausas de memória da aplicação e tempo de resposta da rede. Com o histórico das últimas horas e dos últimos dias, a causa costuma aparecer rápido, porque dá para ver qual camada mudou primeiro.
Sem medição, cada área defende a sua parte. O fornecedor do sistema diz que é infraestrutura, a infraestrutura diz que é o sistema, e a empresa continua lenta. Com medição, cada um recebe a parte que é sua. Num caso recente, a nota levava 93 segundos para sair, contra 3 a 5 esperados. Dois terços do tempo estavam em código customizado, e o resto era infraestrutura mal ajustada. Cada correção foi para quem devia fazer.
Checklist rápido
- Anote quem reclama, em que tela e em que horário.
- Confira se alguma rotina pesada roda durante o expediente.
- Olhe a latência de disco nos horários de lentidão.
- Veja se há sessões bloqueadas no banco quando a tela trava.
- Confira as pausas de memória da aplicação.
- Só pense em servidor maior depois disso, e com os números na mão.
Como a Cloud Labs trabalha nisso
Nos ambientes que a Cloud Labs assume, o monitoramento acompanha servidor, banco e aplicação 24 horas por dia, no mesmo painel. Quando o sistema fica lento, o time acha a causa e resolve o que é de infraestrutura. Quando a causa está no código do sistema, levamos os dados para quem cuida dele, junto com o seu TI.